Le Guide Complet de l'Algorithme de X (2026)
Vous êtes-vous déjà demandé pourquoi certains tweets apparaissent dans votre fil "Pour Vous" plutôt que d'autres ? Pourquoi voyez-vous parfois des publications de personnes que vous ne suivez même pas ? Comment X décide-t-il, parmi les millions de tweets publiés chaque jour, lesquels méritent votre attention ?La réponse tient en un mot : l'algorithme.
X a joué le jeu de la transparence, en rendant une nouvelle fois publique son algorithme. Je l’ai analysé pour vous et nous allons le décortiquer dans cet article.
J’avais déjà fait une précédente analyse disponible sur mon site, de la dernière version publiée à l’été 2025. Cette fois-ci, je me base sur la version publiée aujourd’hui, le 20 janvier 2026.
Avertissement : Ces informations sont basées sur le code public. Les paramètres exacts peuvent varier selon les tests A/B et les configurations en production. X a publie le code mais pas toutes les valeurs de configuraiton qu'ils utilisent en production.
Le fil "Pour Vous" vs le fil "Abonnements"
X propose deux façons de voir les tweets :
- Le fil Pour Vous (For You) qui est un mélange personnalisé des tweets des gens que vous suivez, plus découvertes sélectionnées par l'algorithme.
- Le fil Abonnements (Following), qui montre uniquement les tweets des comptes que vous suivez, par ordre chronologique.
Cet article se concentrera sur le fil "Pour Vous", car c'est là que l'algorithme fait tout son travail.
Navi vs Phoenix : L'ancienne et la nouvelle génération de l'algorithme
L’ancien système que j’avais étudié, Navi, était composé de règles écrites à la main. Par exemple, ça pouvait être des instructions du type : « Si le tweet a plus de 1000 likes, montre-le à plus de monde ». C’est la manière classique de faire des algorithmes : les ingénieurs fixent les règles et l’algorithme est un programme qui exécute ces règles sans réfléchir.
Maintenant, ce système est révolu et se prénomme Phoenix. Comme son nom l’indique, Phoenix est une résurrection pour l’algorithme. Il repart sur de toutes nouvelles bases et n’est plus écrit à la main.
"We have eliminated every single hand-engineered feature and most heuristics from the system."(Traduction : "Nous avons éliminé chaque caractéristique codée à la main et la plupart des règles empiriques du système.")
Concrètement, cela signifie que l'algorithme ne repose plus sur des règles du type "si X alors Y". C'est le modèle d'IA qui détermine ce qui est pertinent pour vous, et non plus des ingénieurs qui définissent des règles.Le nouveau système utilise Grok-1, une intelligence artificielle développée par xAI (l'entreprise d'IA d'Elon Musk). À l'origine, Grok est un chatbot conversationnel, mais X a adapté son architecture pour en faire un système de recommandation.
Pensez à Grok comme au "cerveau" qui analyse chaque tweet et prédit : "Est-ce que cet utilisateur va aimer ça ?"
Architecture du Système : Comment Tout S'organise
Avant de plonger dans les détails, voici une vue d'ensemble du parcours d'un post, depuis sa création jusqu'à son apparition dans votre fil.
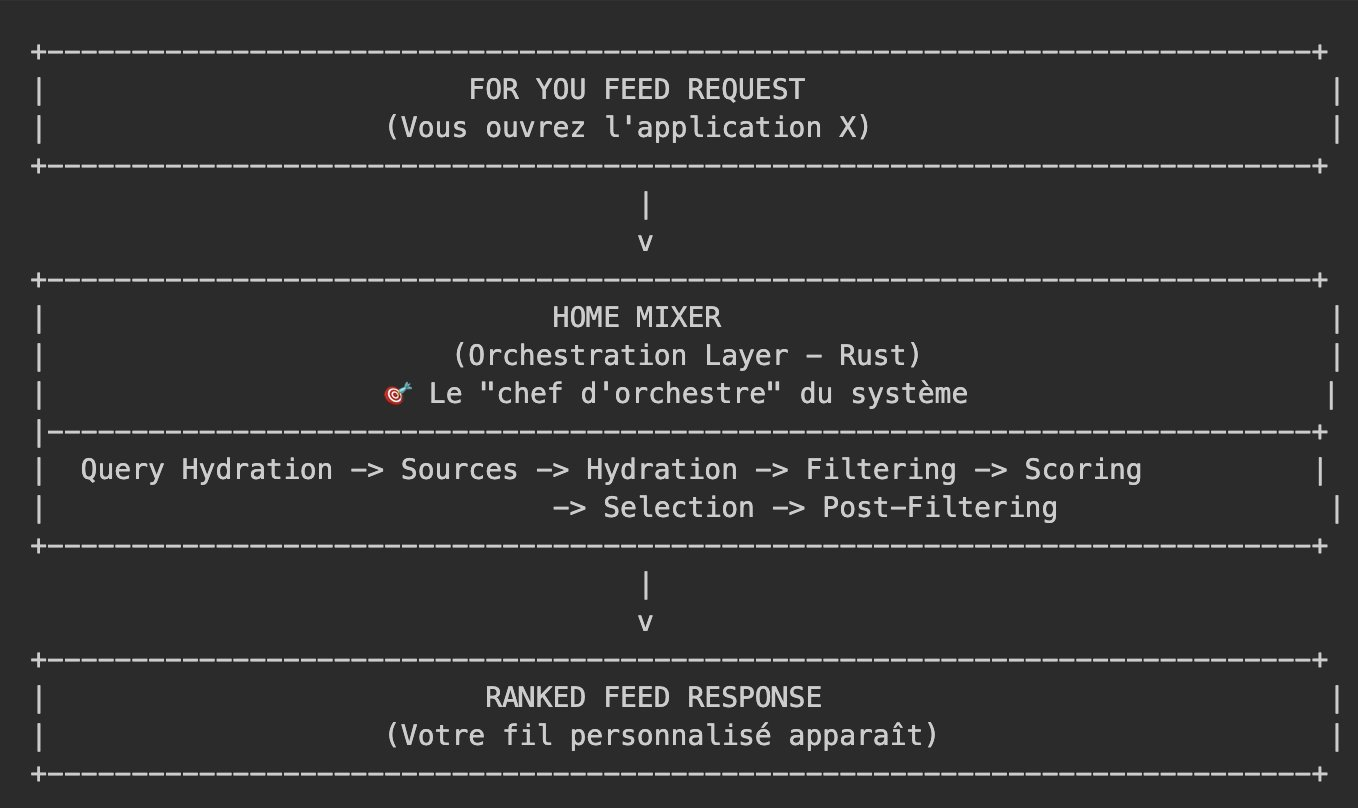
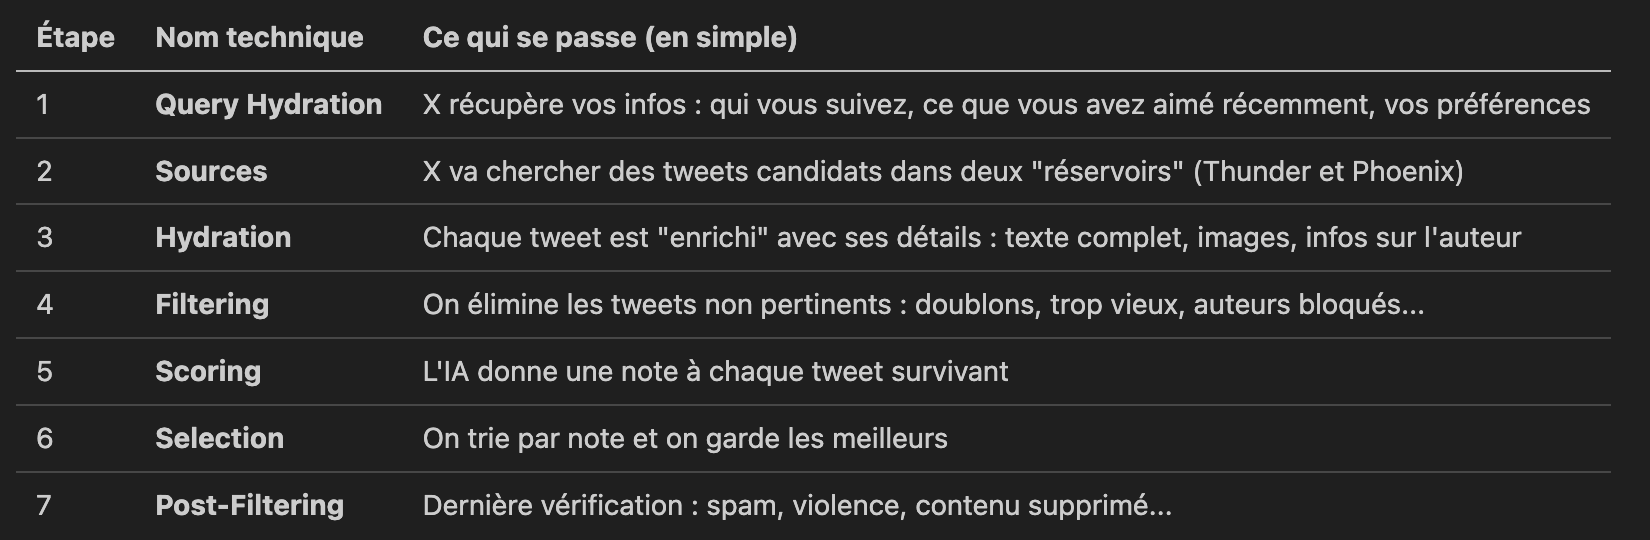
Les 7 Étapes du Pipeline
Voici ce qui se passe à chaque étape :
Les 4 Composants Principaux
1. Home Mixer : Le Chef d'Orchestre
C'est le coordinateur central qui assemble votre fil "Pour Vous". Il reçoit votre demande quand vous ouvrez l'app, ppelle tous les autres composants dans le bon ordre, et assemble la réponse finale.Sans lui, les autres composants ne sauraient pas quand ni comment travailler ensemble. C'est le "cerveau organisationnel" du système.
2. Phoenix : L'Intelligence Artificielle
C'est le modèle d'IA basé sur Grok-1 qui prédit vos réactions.
- Retrieval (Récupération) : Trouve des tweets intéressants parmi des millions
- Ranking (Classement) : Prédit pour chaque tweet : "Quelle est la probabilité que vous l'aimiez ? Le retweetiez ? Le signaliez ?"
C'est Phoenix qui détermine si un tweet vous plaira ou non. C'est le cœur de la personnalisation.
3. Thunder : Le Stockage Ultra-Rapide
C'est une base de données en mémoire qui stocke les tweets récents qui garde en mémoire vive les tweets des dernières heures, qui répond en moins d'une milliseconde aux requêtes et qui stocke séparément les tweets originaux, les réponses, les retweets et les vidéos.Thunder permet d'accéder instantanément aux tweets des comptes que vous suivez (contenu "in-network"), sans interroger une base de données lente.
4. Candidate Pipeline : La Boîte à Outils
C'est un framework réutilisable pour construire des pipelines de recommandation. Il fournit des "briques" standardisées : sources, filtres, scorers, permet d'exécuter des opérations en parallèle et gère les erreurs proprement.
Les 19 Types d'Engagements Prédits par Phoenix
Voici le cœur du système : Phoenix prédit 19 façons différentes dont vous pourriez interagir avec un tweet.
Fichier source : phoenix/runners.py:202-222
ACTIONS: List[str] = [
    "favorite_score",           # Probabilité de like (cœur)
    "reply_score",              # Probabilité de répondre
    "repost_score",             # Probabilité de retweeter
    "photo_expand_score",       # Probabilité d'agrandir la photo
    "click_score",              # Probabilité de cliquer pour voir plus
    "profile_click_score",      # Probabilité de visiter le profil de l'auteur
    "vqv_score",                # Video Quality View (regarder la vidéo en entier)
    "share_score",              # Probabilité de partager
    "share_via_dm_score",       # Probabilité de partager en message privé
    "share_via_copy_link_score",# Probabilité de copier le lien
    "dwell_score",              # Probabilité de s'arrêter sur le tweet
    "quote_score",              # Probabilité de citer avec commentaire
    "quoted_click_score",       # Probabilité de cliquer sur un tweet cité
    "follow_author_score",      # Probabilité de suivre l'auteur
    "not_interested_score",     # Probabilité de dire "pas intéressé"
    "block_author_score",       # Probabilité de bloquer l'auteur
    "mute_author_score",        # Probabilité de masquer l'auteur
    "report_score",             # Probabilité de signaler
    "dwell_time",               # Temps prévu sur le tweet (en secondes)
]
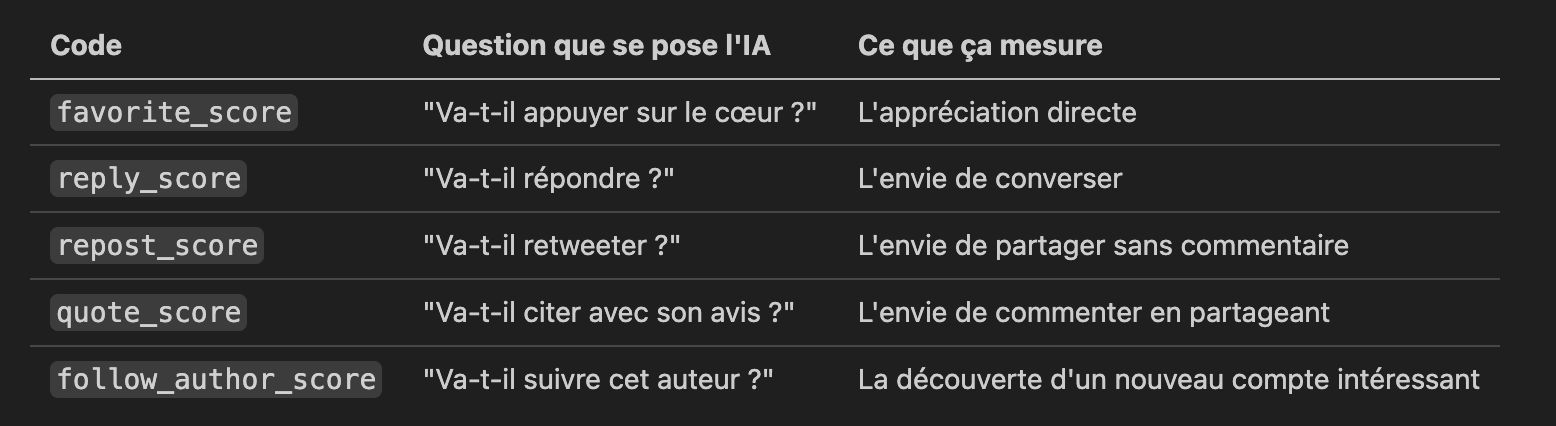
🟢 A) Les Actions d'Appréciation (5 types)
Ces signaux indiquent que vous aimez le contenu :
🔵 B) Les Actions d'Exploration (6 types)
Ces signaux indiquent que vous voulez en savoir plus :
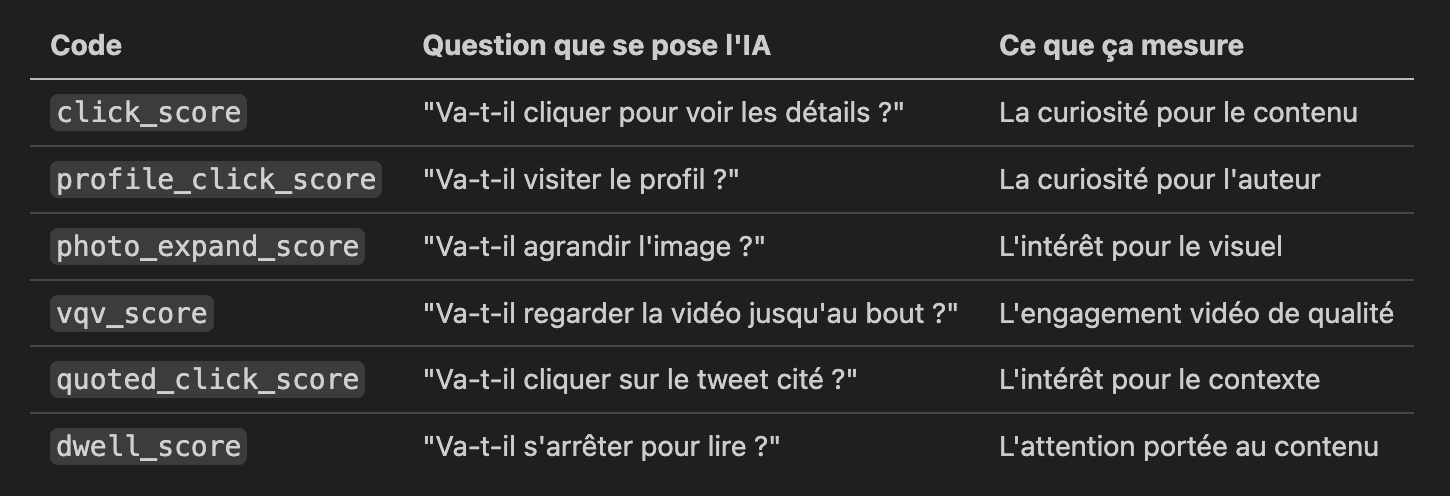
🟣 C) Les Actions de Partage (3 types)
Ces signaux indiquent que vous trouvez le contenu digne d'être partagé :
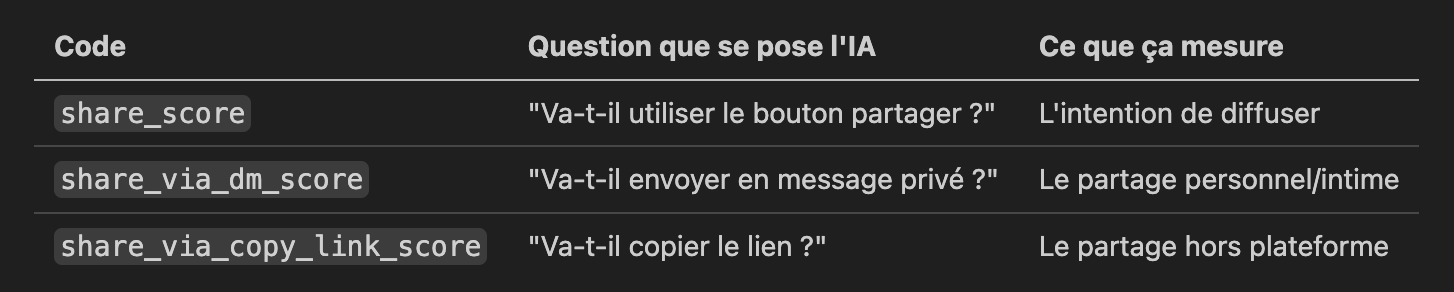
🔴 D) Les Signaux Négatifs (4 types)
Ces signaux indiquent que le contenu ne vous convient pas :
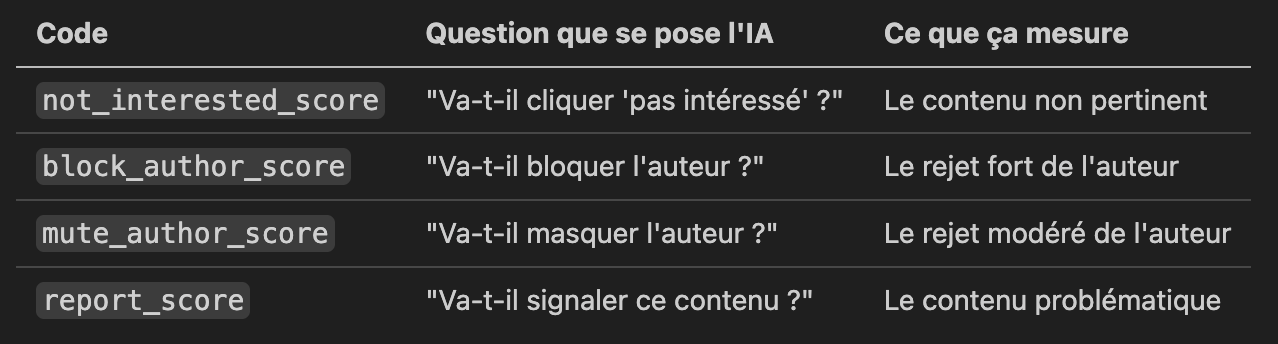
dwell_time : combien de temps vous allez rester sur ce tweet. C'est une valeur en secondes.
Les 18 premiers sont des probabilités (entre 0 et 1). Le dernier (dwell_time) est une durée prédite en secondes.
La Formule de Score : Comment X Note Chaque Tweet
Une fois que Phoenix a prédit les 19 engagements, comment X calcule-t-il le score final d'un tweet ?Imaginez que vous préparez un plat. Chaque ingrédient (engagement) a une importance différente :
- Le sel (like) : très important
- Le poivre (reply) : important aussi
- Le persil (photo_expand) : moins crucial
La formule de score, c'est la recette qui combine tous ces ingrédients avec leurs proportions.
La Fonction d'Application
Fichier source : home-mixer/scorers/weighted_scorer.rs:39-92
// Cette fonction multiplie une probabilité par son poids
// Si la probabilité n'existe pas, on utilise 0
fn apply(score: Option<f64>, weight: f64) -> f64 {
    score.unwrap_or(0.0) * weight
}
Traduction : "Prends la probabilité, multiplie-la par l'importance de cette action. Si on n'a pas de probabilité, considère que c'est 0."
La Formule Complète
fn compute_weighted_score(candidate: &PostCandidate) -> f64 {
    // s = les scores prédits par Phoenix pour ce tweet
    let s: &PhoenixScores = &candidate.phoenix_scores;

    // Vérifie si ce tweet peut bénéficier du boost vidéo
    let vqv_weight = Self::vqv_weight_eligibility(candidate);

    // On additionne chaque probabilité × son poids
    let combined_score =
        // === ENGAGEMENTS POSITIFS ===
        Self::apply(s.favorite_score, p::FAVORITE_WEIGHT)           // P(like) × poids_like
      + Self::apply(s.reply_score, p::REPLY_WEIGHT)                 // P(réponse) × poids_réponse
      + Self::apply(s.retweet_score, p::RETWEET_WEIGHT)             // P(retweet) × poids_retweet
      + Self::apply(s.photo_expand_score, p::PHOTO_EXPAND_WEIGHT)   // P(agrandir_photo) × poids
      + Self::apply(s.click_score, p::CLICK_WEIGHT)                 // P(clic) × poids_clic
      + Self::apply(s.profile_click_score, p::PROFILE_CLICK_WEIGHT) // P(clic_profil) × poids
      + Self::apply(s.vqv_score, vqv_weight)                        // P(vidéo_complète) × poids_vidéo
      + Self::apply(s.share_score, p::SHARE_WEIGHT)                 // P(partage) × poids_partage
      + Self::apply(s.share_via_dm_score, p::SHARE_VIA_DM_WEIGHT)   // P(partage_DM) × poids
      + Self::apply(s.share_via_copy_link_score, p::SHARE_VIA_COPY_LINK_WEIGHT) // P(copie_lien) × poids
      + Self::apply(s.dwell_score, p::DWELL_WEIGHT)                 // P(attention) × poids
      + Self::apply(s.quote_score, p::QUOTE_WEIGHT)                 // P(citation) × poids
      + Self::apply(s.quoted_click_score, p::QUOTED_CLICK_WEIGHT)   // P(clic_citation) × poids
      + Self::apply(s.dwell_time, p::CONT_DWELL_TIME_WEIGHT)        // temps_prévu × poids_temps
      + Self::apply(s.follow_author_score, p::FOLLOW_AUTHOR_WEIGHT) // P(suivre_auteur) × poids
        // === ENGAGEMENTS NÉGATIFS ===
      + Self::apply(s.not_interested_score, p::NOT_INTERESTED_WEIGHT)  // P(pas_intéressé) × poids_négatif
      + Self::apply(s.block_author_score, p::BLOCK_AUTHOR_WEIGHT)      // P(bloquer) × poids_négatif
      + Self::apply(s.mute_author_score, p::MUTE_AUTHOR_WEIGHT)        // P(masquer) × poids_négatif
      + Self::apply(s.report_score, p::REPORT_WEIGHT);                 // P(signaler) × poids_négatif

    // Ajustement final pour équilibrer positif et négatif
    Self::offset_score(combined_score)
}
⚠️ IMPORTANT : Les valeurs des poids (FAVORITE_WEIGHT, REPLY_WEIGHT, etc.) sont exclues du code open source.
La fonction offset_score est un ajustement qui équilibre les contributions positives et négatives.
Sans entrer dans les détails mathématiques :
- Les poids positifs (like, share...) augmentent le score
- Les poids négatifs (block, mute...) diminuent le score
- L'offset recalibre le tout pour avoir des scores comparables
Le Boost Vidéo (VQV)
Les vidéos peuvent recevoir un traitement spécial dans l'algorithme.
Fichier source : home-mixer/scorers/weighted_scorer.rs:72-81
// Vérifie si la vidéo est éligible au boost
fn vqv_weight_eligibility(candidate: &PostCandidate) -> f64 {
    // Si le tweet contient une vidéo ET que sa durée dépasse le seuil minimum
    if candidate
        .video_duration_ms
        .is_some_and(|ms| ms > p::MIN_VIDEO_DURATION_MS)
    {
        p::VQV_WEIGHT  // → La vidéo obtient le boost complet
    } else {
        0.0  // → Pas de boost pour les vidéos trop courtes ou les tweets sans vidéo
    }
}
En résumé
- Tweet sans vidéo -> pas de boost
- Vidéo trop courte (< seuil) -> pas de boost
- Vidéo assez longue (> seuil) -> boost appliqué
X veut encourager le contenu vidéo de qualité. Les vidéos très courtes (quelques secondes) ne bénéficient pas du même traitement que les vidéos plus substantielles.
La valeur exacte de MIN_VIDEO_DURATION_MS (durée minimale) et VQV_WEIGHT (importance du boost) sont dans le module params qui n'est pas public.
La Pénalité Out-of-Network (OON)
Vous vous souvenez des deux sources de tweets ? In-Network (comptes suivis) et Out-of-Network (découvertes) ?
Les tweets Out-of-Network reçoivent une pénalité pour favoriser le contenu des comptes que vous suivez.
- In-Network veut dire dans votre réseau. Ce sont les comptes que vous suivez. Par exemple moi meme @aurealibe que vous suivez
- Out-of-Network (OON) veiut dire hors de votre reseau. ce sont les comptes que vous ne suivez pas. Par exemple un post viral de @inconnu que vous ne suivez pas
Fichier source : home-mixer/scorers/oon_scorer.rs:1-39
// Commentaire original : "Prioritize in-network candidates over out-of-network candidates"
// Traduction : "Favoriser les candidats in-network par rapport aux out-of-network"
pub struct OONScorer;

// Le calcul du nouveau score (lignes 20-23)
let updated_score = c.score.map(|base_score| match c.in_network {
    Some(false) => base_score * p::OON_WEIGHT_FACTOR,  // Tweet OON → score × facteur de pénalité
    _ => base_score,                                    // Tweet in-network → score inchangé
});
Pour faire simple :
- tweet d'un compte que vous suivez → Score reste intact (× 1.0)
- tweet d'un compte inconnu → Score réduit (× OON_WEIGHT_FACTOR)
X considère que le contenu des personnes que vous avez choisi de suivre devrait être prioritaire. Les "découvertes" sont un bonus, pas le plat principal.
La valeur exacte de OON_WEIGHT_FACTOR est cachée. Si c'est 0.75 par exemple, un tweet OON avec un score de 100 serait ramené à 75.
Limitation du nombre de Tweets par Personne
Le système utilise une décroissance exponentielle : chaque tweet supplémentaire d'un même auteur a de moins en moins de chances d'apparaître.
Fichier source : home-mixer/scorers/author_diversity_scorer.rs🕢
/// Diversifier les auteurs servis dans une seule réponse de fil
pub struct AuthorDiversityScorer {
    decay_factor: f64,  // Facteur de décroissance (ex: 0.5)
    floor: f64,         // Plancher minimum (ex: 0.1)
}

// Formule de décroissance exponentielle (lignes 29-31)
fn multiplier(&self, position: usize) -> f64 {
    // multiplicateur = (1 - plancher) × facteur^position + plancher
    (1.0 - self.floor) * self.decay_factor.powf(position as f64) + self.floor
}
Comment ça fonctionne concrètement ?
for (original_idx, candidate) in ordered {
    // Pour chaque tweet, on regarde combien de fois on a déjà vu cet auteur
    let entry = author_counts.entry(candidate.author_id).or_insert(0);
    let position = *entry;  // 0 pour le 1er tweet, 1 pour le 2e, etc.
    *entry += 1;

    // On calcule le multiplicateur basé sur la position
    let multiplier = self.multiplier(position);
    // On ajuste le score
    let adjusted_score = candidate.weighted_score.map(|score| score * multiplier);
Exemple avec decay_factor = 0.5 et floor = 0.1
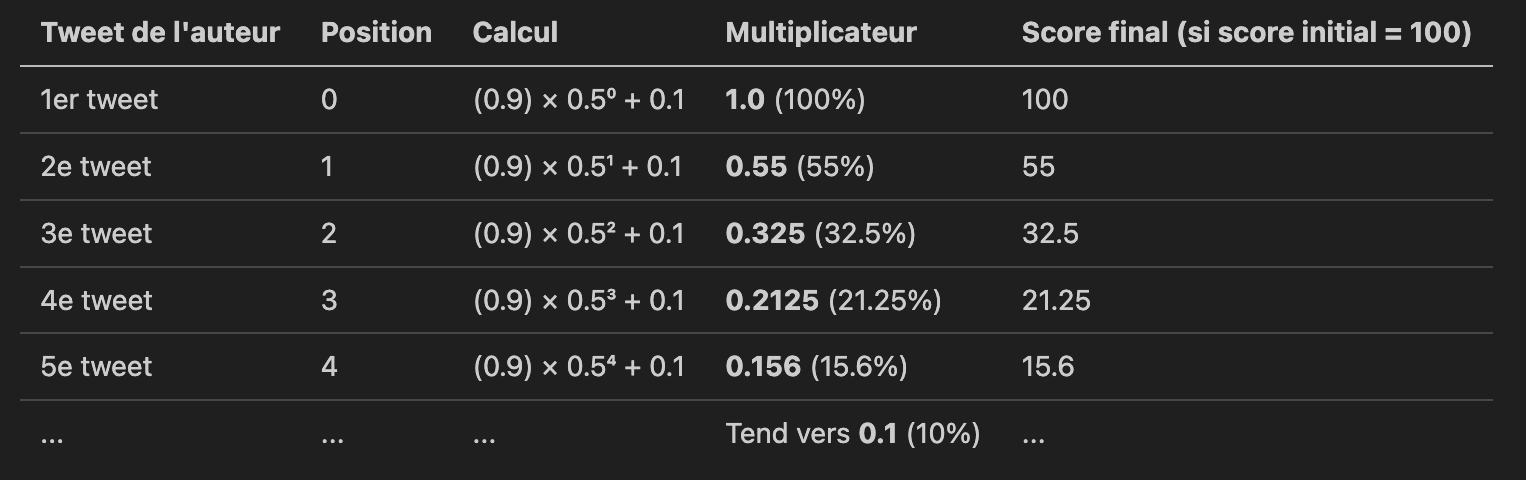
Il n'y a pas de limite dure de tweets postés. Par contre, il y a une réduction progressive. Un auteur très populaire peut théoriquement avoir 10 tweets dans votre fil, mais les tweets 5, 6, 7... auront des scores très réduits et seront probablement battus par d'autres contenus. Il faut donc limiter son nombre de posts pour maximiser ses vues.
Les 12 Filtres du Pipeline
Avant et après le scoring, les tweets passent par une série de "gardiens" qui vérifient différentes conditions.
Fichier source : home-mixer/candidate_pipeline/phoenix_candidate_pipeline.rs:108-143Imaginez chaque tweet comme un passager qui doit passer plusieurs contrôles :
- Vérification du passeport (tweet valide ?)
- Détection de métaux (contenu problématique ?)
- Contrôle des bagages (médias appropriés ?)
Si un tweet échoue à un contrôle, il est éliminé.
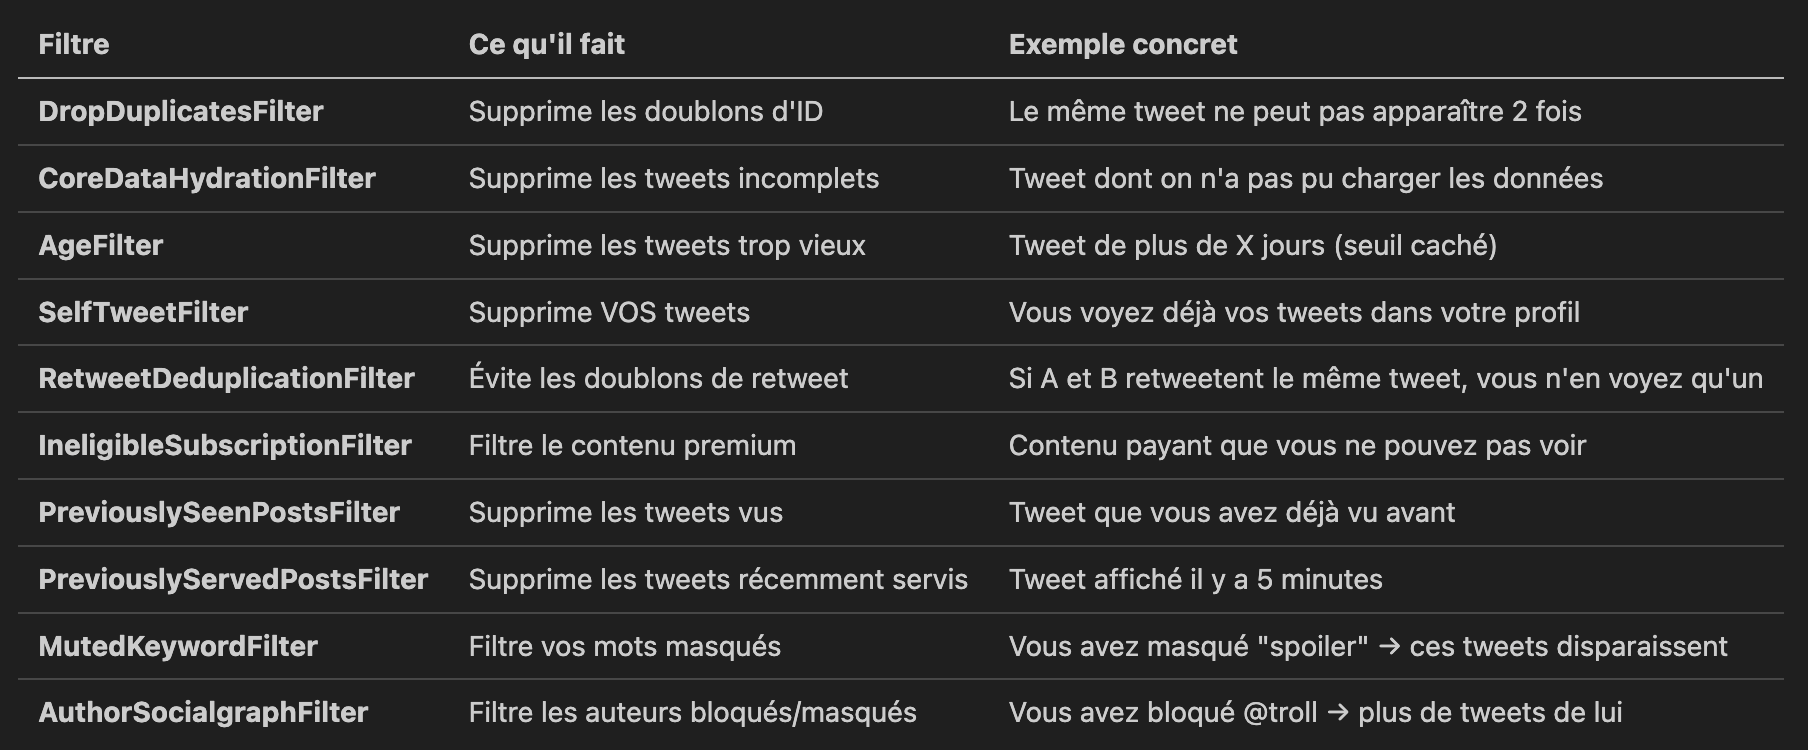
Les 10 Filtres Pré-Sélection (avant le scoring)
Ces filtres éliminent les tweets avant même qu'ils soient notés :
let filters: Vec<Box<dyn Filter<ScoredPostsQuery, PostCandidate>>> = vec![
    Box::new(DropDuplicatesFilter),           // Supprime les tweets en double
    Box::new(CoreDataHydrationFilter),        // Supprime les tweets mal chargés
    Box::new(AgeFilter::new(...)),            // Supprime les tweets trop vieux
    Box::new(SelfTweetFilter),                // Supprime VOS propres tweets
    Box::new(RetweetDeduplicationFilter),     // Évite de voir le même contenu retweeté 2x
    Box::new(IneligibleSubscriptionFilter),   // Supprime le contenu premium inaccessible
    Box::new(PreviouslySeenPostsFilter),      // Supprime les tweets déjà vus
    Box::new(PreviouslyServedPostsFilter),    // Supprime les tweets déjà affichés cette session
    Box::new(MutedKeywordFilter::new()),      // Supprime les tweets avec vos mots masqués
    Box::new(AuthorSocialgraphFilter),        // Supprime les tweets d'auteurs bloqués/masqués
];
Les 2 Filtres Post-Sélection (après le scoring)
Ces filtres s'appliquent sur les tweets déjà notés et sélectionnés :
let post_selection_filters: Vec<Box<dyn Filter<ScoredPostsQuery, PostCandidate>>> =
vec![Box::new(VFFilter), Box::new(DedupConversationFilter)];- VFFilter : il vérifie la "visibilité" du contenu. Par exemple, il peut supprimer spam, violence, NSFW, gore, etc, via un service externe
- DedupConversationFilter : il garde un seul tweet par conversation. Si un fil a 10 réponses, on garde la meilleure.
Autres filtres sur les posts
Le Filtrage de Visibilité (VF)
Point important à comprendre : Ce n'est pas Grok/Phoenix qui décide si un tweet est du spam ou contient de la violence. C'est un service externe appelé "Visibility Filtering" (VF).
Le Code :
Fichier source : home-mixer/filters/vf_filter.rs + phoenix_candidate_pipeline.rs:56-58
// Le filtre VF appelle un service EXTERNE, pas le modèle Phoenix
use xai_visibility_filtering::vf_client::{
    ProdVisibilityFilteringClient,  // Client pour le service de filtrage de visibilité
    VisibilityFilteringClient,
};
La Logique du Filtre :
Fichier source : home-mixer/filters/vf_filter.rs:25-33
// Détermine si un tweet doit être supprimé
fn should_drop(reason: &Option<FilteredReason>) -> bool {
    match reason {
        // Si le service de sécurité dit "Drop" → on supprime
        Some(FilteredReason::SafetyResult(safety_result)) => {
            matches!(safety_result.action, Action::Drop(_))
        }
        // Si autre raison de filtrage → on supprime aussi
        Some(_) => true,
        // Pas de raison de filtrage → on garde
        None => false,
    }
}
Ce que le Service VF Vérifie
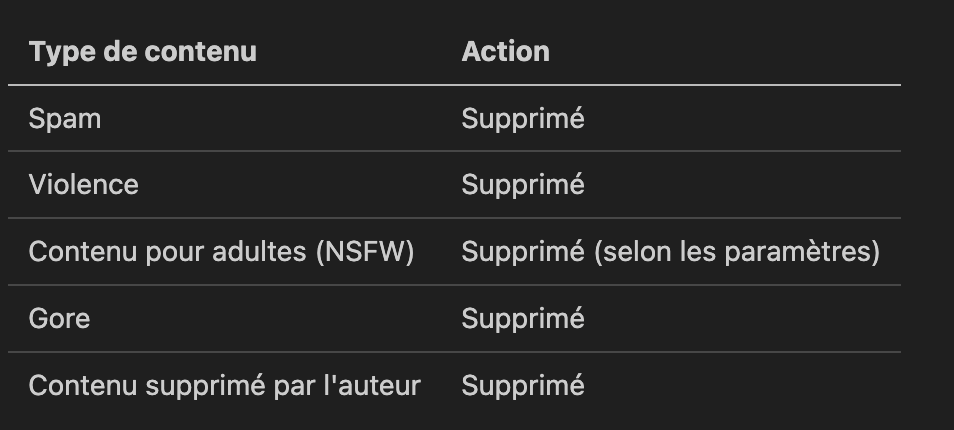
Pourquoi cette séparation ?Phoenix = Expert en "ce qui vous plaira"
VF = Expert en "ce qui est approprié"
Ce sont deux questions différentes. Un tweet violent pourrait techniquement "plaire" (au sens de générer des clics), mais il doit quand même être filtré.
Il y a également une chose à noter sur le fonctionnement exact du filtrage VF : cet outil de modération en lui-même n’est pas open source. C’est une boîte noire. Nous ne savons rien de son fonctionnement, si ce n’est qu’il est appelé dans le code.
Il agit comme un filtre de modération qui invisibilise et supprime du contenu sans que nous sachions quel type de contenu est visé ni quelles sont les règles appliquées. C’est ce filtre VF qui se charge probablement de bloquer du contenu quand un État en fait la demande, ou même de manière arbitraire par X.
Les Filtres de Déduplication : Éviter les Répétitions
- RetweetDeduplicationFilter : évite de voir le même contenu retweeté plusieurs fois.
Fichier source : home-mixer/filters/retweet_deduplication_filter.rs🕟
/// Déduplique les retweets, gardant seulement la première occurrence d'un tweet
/// (qu'il soit original ou retweeté).
pub struct RetweetDeduplicationFilter;

for candidate in candidates {
    match candidate.retweeted_tweet_id {
        Some(retweeted_id) => {
            // C'est un retweet → on vérifie si on a déjà vu le tweet original
            if seen_tweet_ids.insert(retweeted_id) {
                // Pas encore vu → on garde
                kept.push(candidate);
            } else {
                // Déjà vu ce contenu → on supprime
                removed.push(candidate);
            }
        }
        None => {
            // C'est un tweet original → on le marque comme vu et on garde
            seen_tweet_ids.insert(candidate.tweet_id as u64);
            kept.push(candidate);
        }
    }
}
Exemple :
- @alice tweete "Bonjour !"
- @bob retweete le tweet de @alice
- @charlie retweete aussi le tweet de @alice
- Vous voyez uniquement le premier (celui de @alice ou celui de @bob), pas les 3
- DedupConversationFilter : Ce filtre évite d'afficher plusieurs tweets d'une même conversation.
Fichier source : home-mixer/filters/dedup_conversation_filter.rs:1-52
/// Garde seulement le candidat avec le meilleur score par branche d'une conversation
pub struct DedupConversationFilter;

// On garde uniquement le tweet avec le meilleur score par conversation
if score > *best_score {
    // Nouveau meilleur score → on remplace
    let previous = std::mem::replace(&mut kept[*kept_idx], candidate);
    removed.push(previous);  // L'ancien meilleur va dans "supprimé"
    *best_score = score;
} else {
    // Score inférieur → on supprime ce candidat
    removed.push(candidate);
}
Exemple :
- Un thread de 10 tweets existe sur un sujet
- Plusieurs tweets de ce thread ont un bon score
- On ne garde que celui avec le meilleur score pour éviter de surcharger votre fil avec la même conversation
Le Filtre d'Âge : Pas de Tweets Trop Vieux
Les tweets au-delà d'un certain âge sont automatiquement filtrés.
Fichier source : home-mixer/filters/age_filter.rs:1-39
/// Filtre qui supprime les tweets plus vieux qu'une durée spécifiée.
pub struct AgeFilter {
    pub max_age: Duration,  // Âge maximum autorisé
}

fn is_within_age(&self, tweet_id: i64) -> bool {
    // Utilise le "Snowflake ID" pour extraire la date de création du tweet
    snowflake::duration_since_creation_opt(tweet_id)
        .map(|age| age <= self.max_age)  // Le tweet est-il assez récent ?
        .unwrap_or(false)                 // Si on ne peut pas déterminer l'âge, on supprime
}
La valeur exacte de max_age est cachée dans le module params. On ne sait pas si c'est 24h, 48h, ou autre.
Le Modèle Phoenix : Isolation des Candidats
C'est l'une des innovations clés du système : chaque tweet est noté indépendamment des autres.Imaginez un examen où chaque élève (tweet) est dans une salle séparée :
- Chaque élève peut voir le sujet de l'examen (votre profil utilisateur)
- Chaque élève peut voir l'historique des examens précédents (vos engagements passés)
- Mais les élèves ne peuvent PAS voir les copies des autres (les autres tweets candidats)
Si les tweets pouvaient "voir" les autres candidats, le score d'un tweet dépendrait de quels autres tweets sont dans le lot. Ça poserait des problèmes :
- Résultats incohérents d'une requête à l'autre
- Impossibilité de mettre les scores en cache
Avec l'isolation, le score d'un tweet est toujours le même, peu importe quels autres tweets sont évalués en même temps.
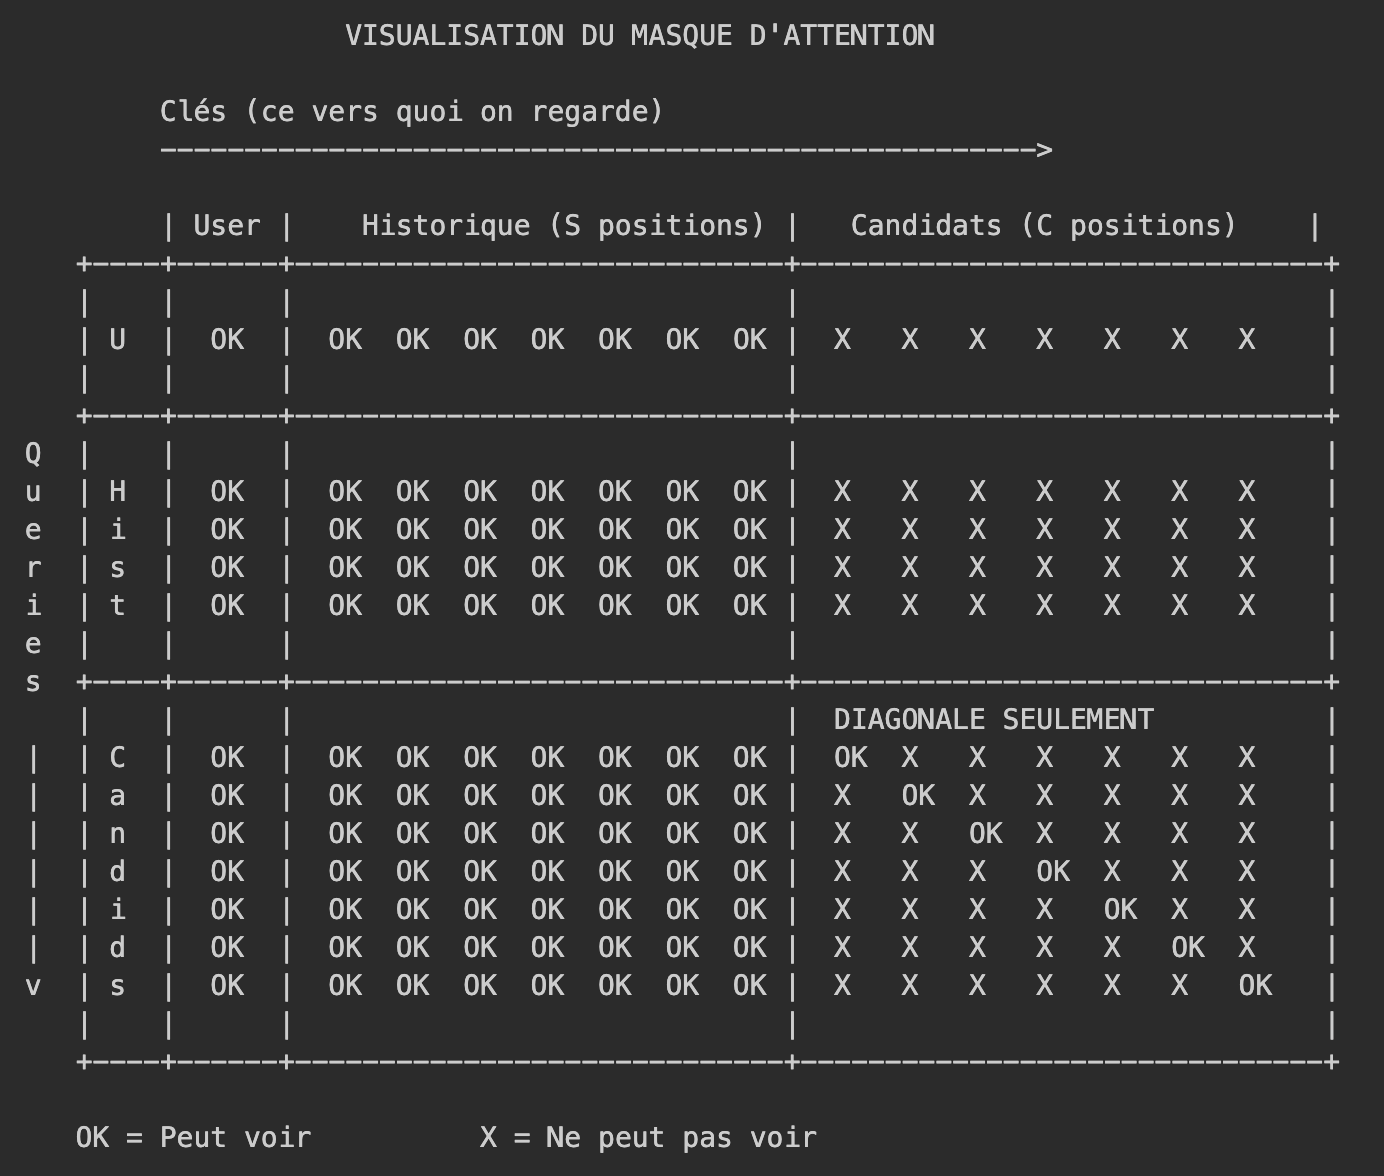
Le Masque d'Attention
Fichier source : phoenix/grok.py:39-71
def make_recsys_attn_mask(
    seq_len: int,               # Longueur totale de la séquence
    candidate_start_offset: int, # Où commencent les candidats
    dtype: jnp.dtype = jnp.float32,
) -> jax.Array:
    """Crée un masque d'attention pour l'inférence du système de recommandation.

    Crée un masque où :
    - Positions 0 à candidate_start_offset-1 (utilisateur+historique) : attention causale normale
    - Positions candidate_start_offset et après (candidats) : peuvent voir l'utilisateur+historique
      ET eux-mêmes (self-attention), mais PAS les autres candidats

    Cela garantit que chaque candidat est noté indépendamment basé sur le contexte utilisateur+historique.
    """
    # On commence avec un masque causal pour toute la séquence
    causal_mask = jnp.tril(jnp.ones((1, 1, seq_len, seq_len), dtype=dtype))

    # On met à zéro l'attention candidat-vers-candidat (bloc en bas à droite)
    attn_mask = causal_mask.at[:, :, candidate_start_offset:, candidate_start_offset:].set(0)

    # On rajoute la self-attention pour les candidats (diagonale du bloc candidat)
    candidate_indices = jnp.arange(candidate_start_offset, seq_len)
    attn_mask = attn_mask.at[:, :, candidate_indices, candidate_indices].set(1)

    return attn_mask
Ce que chaque tweet peut voir :
- Votre profil utilisateur -> oui ✅
- Votre historique d'engagement -> oui ✅
- Lui-même (self-attention) -> oui ✅
- Les autres tweets candidats -> non ❌
Visualisation du Masque
Le Modèle Two-Tower : Comment X Trouve les Tweets OON
Pour trouver des tweets intéressants parmi des millions (Out-of-Network), Phoenix utilise un modèle "two-tower" (deux tours).
Imaginez une application de rencontre comme Tinder :
- Votre profil : Vos goûts, vos intérêts, votre historique
- Les profils des autres : Leurs caractéristiques
- Le matching : On compare les deux pour trouver des correspondances
Le modèle two-tower fait exactement ça, mais pour les tweets !
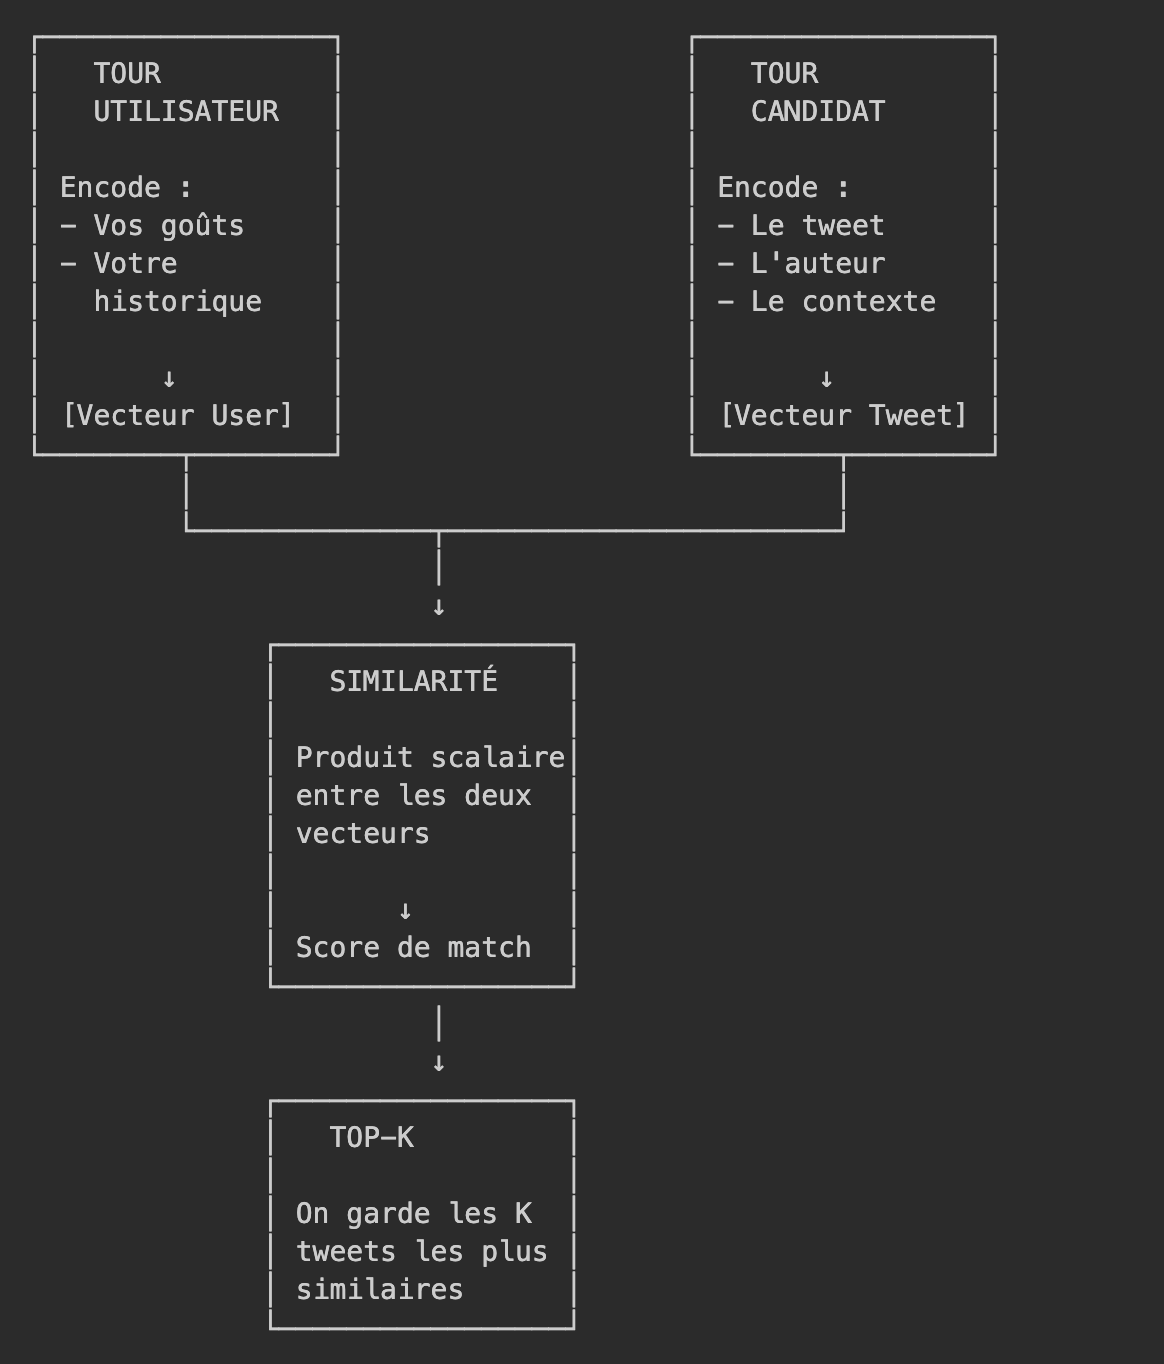
User Tower (Tour Utilisateur)
Fichier source : phoenix/recsys_retrieval_model.py:206-276
def build_user_representation(
    self,
    batch: RecsysBatch,
    recsys_embeddings: RecsysEmbeddings,
) -> Tuple[jax.Array, jax.Array]:
    """Construit la représentation de l'utilisateur à partir de ses caractéristiques et son historique.

    Utilise le transformer Phoenix pour encoder les embeddings utilisateur + historique
    en un seul vecteur de représentation utilisateur.
    """
    # ... encodage via transformer ...

    # Normalisation L2 : on met tous les vecteurs à la même "longueur"
    user_norm_sq = jnp.sum(user_representation**2, axis=-1, keepdims=True)
    user_norm = jnp.sqrt(jnp.maximum(user_norm_sq, EPS))
    user_representation = user_representation / user_norm

    return user_representation, user_norm
On transforme toutes vos infos (qui vous êtes, ce que vous avez aimé...) en un vecteur de nombres qui représente vos goûts.
Candidate Tower (Tour Candidat)
Fichier source : phoenix/recsys_retrieval_model.py:47-99
@dataclass
class CandidateTower(hk.Module):
    """Tour candidat qui projette les embeddings post+auteur dans un espace partagé."""

    def __call__(self, post_author_embedding: jax.Array) -> jax.Array:
        # Réseau à 2 couches : input → 2*D → silu → D
        hidden = jnp.dot(post_author_embedding.astype(proj_1.dtype), proj_1)
        hidden = jax.nn.silu(hidden)  # Fonction d'activation SiLU
        candidate_embeddings = jnp.dot(hidden.astype(proj_2.dtype), proj_2)

        # Normalisation L2 finale
        candidate_norm_sq = jnp.sum(candidate_embeddings**2, axis=-1, keepdims=True)
        candidate_norm = jnp.sqrt(jnp.maximum(candidate_norm_sq, EPS))
        candidate_representation = candidate_embeddings / candidate_norm
On transforme chaque tweet + son auteur en un vecteur de nombres qui représente son "essence".
La Recherche par Similarité
def _retrieve_top_k(
    self,
    user_representation: jax.Array,  # Vecteur utilisateur
    corpus_embeddings: jax.Array,     # Vecteurs de tous les tweets
    top_k: int,                        # Combien de résultats on veut
    corpus_mask: Optional[jax.Array] = None,
) -> Tuple[jax.Array, jax.Array]:
    # Produit scalaire entre utilisateur et corpus
    # Plus le score est élevé, plus le tweet est "compatible" avec l'utilisateur
    scores = jnp.matmul(user_representation, corpus_embeddings.T)

    # On récupère les Top-K tweets avec les meilleurs scores
    top_k_scores, top_k_indices = jax.lax.top_k(scores, top_k)
On compare le vecteur "vous" avec le vecteur de chaque tweet. Plus le score est élevé, plus le tweet est "compatible" avec l'utilisateur. Les tweets dont le vecteur est le plus "proche" du vôtre sont récupérés.
Récupération du Nombre de Followers
Le nombre de followers de chaque auteur est récupéré et peut influencer le scoring dun post.
Fichier source : home-mixer/candidate_hydrators/gizmoduck_hydrator.rs:51-52
// Le nombre de followers de l'auteur est récupéré et stocké
let author_followers_count: Option<i32> =
    user_counts.map(|x| x.followers_count).map(|x| x as i32);
L'utilisation exacte de cette donnée dans le scoring est dans le module params exclu. On ne sait pas quel poids lui est donné.
Ce Qui Est Exclu du Code Open Source
Module params (exclu pour sécurité)Les paramètres suivants sont définis dans le module params qui n'est PAS public :
Poids des engagements :
- FAVORITE_WEIGHT - Poids du like
- REPLY_WEIGHT - Poids de la réponse
- RETWEET_WEIGHT - Poids du retweet
- ... et tous les autres poids
Paramètres de l'algorithme :
- OON_WEIGHT_FACTOR - Facteur de pénalité Out-of-Network
- AUTHOR_DIVERSITY_DECAY - Décroissance de la diversité auteur
- AUTHOR_DIVERSITY_FLOOR - Plancher de la diversité auteur
- MAX_POST_AGE - Âge maximum des posts
- MIN_VIDEO_DURATION_MS - Durée minimum pour le boost vidéo
- VQV_WEIGHT - Poids du boost vidéo
- RESULT_SIZE - Nombre de résultats retournés
Paramètres de normalisation :
- WEIGHTS_SUM - Somme des poids positifs
- NEGATIVE_WEIGHTS_SUM - Somme des poids négatifs
- NEGATIVE_SCORES_OFFSET - Offset pour équilibrer les scores négatifs
Aussi exclus
- Module clients (intégrations services externes)
- Module util (fonctions utilitaires)
- Poids du modèle entraîné (les milliards de paramètres de l'IA)
Pourquoi ces exclusions ?Pour des raisons de sécurité. Si ces valeurs étaient publiques, des acteurs malveillants pourraient manipuler l'algorithme pour promouvoir artificiellement du contenu, optimiser du spam pour contourner les filtre et exploiter des failles dans la logique de scoring.
Concernant le filtre VF, le fait qu’il ne soit pas open source est néanmoins plus problématique, car c’est cet outil qui invisibilise certains contenus et nous n’avons aucun moyen de savoir quel contenu est vraiment toléré ou interdit.
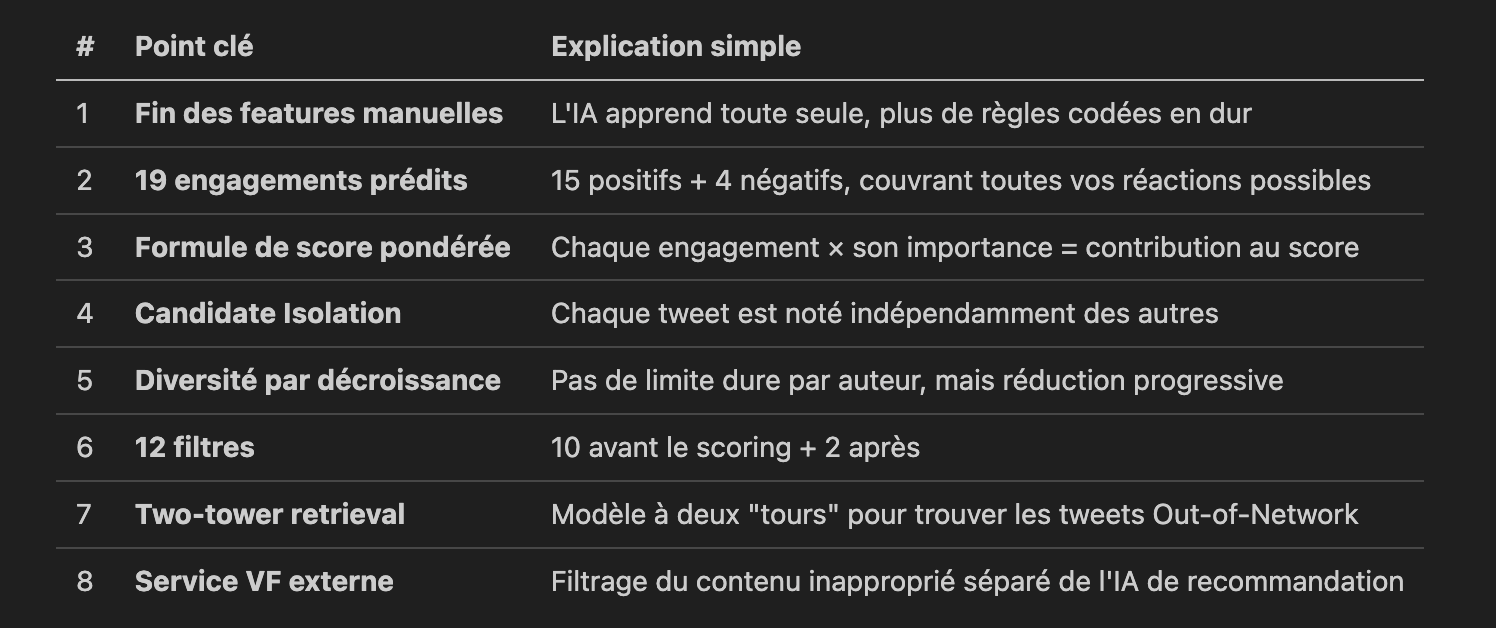
Résumé : Les 8 Points Clés du Nouvel Algorithme
4 conseils pour gagner des followers
1- Ne publiez pas trop de posts
Chaque post supplémentaire que vous publiez dans le même fil voit son score réduit de façon exponentielle. Mieux vaut un seul excellent tweet que cinq moyens d’affilée.
2- Ciblez d’abord votre audience existante
Les posts sont pénalisés quand ils traitent de sujets très différents de vos thématiques habituelles. Vos abonnés voient vos contenus en priorité. Concentrez-vous d’abord sur eux pour maximiser la portée initiale et créer le momentum nécessaire à une bonne diffusion.
3- Évitez le spam
Le filtrage VF supprime ou enterre le contenu jugé spam. Qualité > Quantité. L’algorithme détecte très bien les comportements répétitifs ou excessifs.
4- Faites réagir POSITIVEMENT
Un tweet qui génère beaucoup de blocks ou de mutes sera enterré. La controverse fonctionne seulement si elle produit plus de likes, retweets et réponses positives que de réactions négatives.
CHECKLIST - LES ÉLÉMENTS À VÉRIFIER AVANT DE POSTER
ENGAGEMENT POSITIF (Boosts)
- Likes - Les tweets génèrent-ils des likes rapidement après publication ?
- Replies - Les tweets déclenchent-ils des conversations ? Posez-vous des questions ?
- Retweets - Le contenu est-il assez pertinent pour être partagé ? Valeur informationnelle ou émotionnelle forte ?
- Quote Tweets - Le contenu invite-t-il à ajouter un commentaire ? Matière à débat ?
- Follows - Le tweet montre-t-il votre expertise/valeur unique qui donne envie de follow ?
CONTENU VIDÉO (Boost Spécial)
6. Durée vidéo suffisante - Les vidéos dépassent-elles le seuil minimum ? Les vidéos très courtes (<5 s) n'ont PAS le boost VQV.
7. Vidéos regardées jusqu'au bout (VQV) - Les viewers regardent-ils la vidéo en entier ? Le hook des premières secondes est-il captivant ?MÉDIAS & CLICS
8. Images qui incitent à agrandir - Les images contiennent-elles des détails à découvrir ? La preview donne-t-elle envie de cliquer ?
9. Clics sur le tweet - Le tweet incite-t-il à cliquer pour voir les réponses ou les détails ?
10. Clics sur le profil - Le contenu donne-t-il envie de visiter le profil ? Reflète-t-il une expertise intéressante
TEMPS DE LECTURE
11. Dwell Time - Le contenu retient-il l'attention plusieurs secondes ? Threads captivants ? Bonnes accroches ?
PARTAGE & VIRALITÉ
12. Partage (Share) - Le contenu vaut-il d'être partagé via le bouton share ?
13. Partage en DM - Le contenu est-il assez intéressant pour être envoyé à un ami en privé ?
14. Copie du lien - Le tweet mérite-t-il d'être sauvegardé ou partagé en dehors de X ?
SIGNAUX NÉGATIFS (Pénalités)
15. Éviter "Not Interested" - Le contenu évite-t-il d'être hors-sujet pour votre audience ? Pas de thèmes qui font fuir ?
16. Éviter les Blocks - Le contenu n'est-il pas agressif ou offensant ? Respect des limites de l'audience ?
17. Éviter les Mutes - Pas de spam perçu ? Contenu pas trop répétitif au point d'agacer ?
18. Éviter les Reports - Respect des règles de la plateforme ? Pas de désinformation ou harcèlement ?
MÉCANISMES SPÉCIAUX
19. Diversité de publication (Author Diversity) - Espacez-vous vos tweets dans le temps ?Décroissance exponentielle (ex. valeurs inventées pour lexemple) :
- 1er tweet : 100 %
- 2ème tweet : ~55 %
- 3ème tweet : ~33 %
- 4ème tweet : ~21 %
- 5ème+ : ~10 % (plancher)
20. Audience engagée (In-Network) - Vos followers interagissent-ils régulièrement ? Le contenu passe d'abord par votre réseau avant de sortir vers les autres. Pénalité pour le contenu out-of-network.
FILTRES AUTOMATIQUES (Élimination immédiate)
- AgeFilter - Tweets vieux (>24-48 h) invisibilisés
- MutedKeywordFilter - Mots-clés sensibles/controversés = filtré
- VFFilter - Spam, violence, NSFW, gore = filtré
- RetweetDeduplicationFilter - RT du même contenu plusieurs fois = pénalisé
Conclusion
Vous savez maintenant comment X décide ce que vous voyez dans votre fil "Pour Vous". Le système est sophistiqué mais sa logique est compréhensible :
- X observe vos comportements (likes, clics, temps passé...)
- L'IA Phoenix prédit vos réactions futures à chaque tweet
- Une formule pondérée calcule un score pour chaque tweet
- Des filtres éliminent les contenus inappropriés
- Vous voyez les tweets avec les meilleurs scores
La transparence de X en publiant ce code est remarquable. Elle permet de comprendre, critiquer, et même suggérer des améliorations au système qui influence ce que des centaines de millions de personnes voient chaque jour.
X est le seul réseau social à partager son algorithme.